从计算任务出发,理解工艺选择
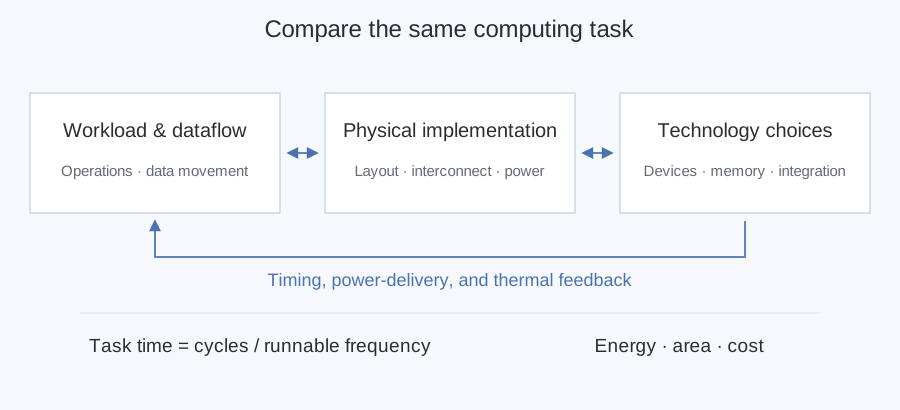
假设我们想改进一个矩阵乘法引擎,可以从哪里入手?增加计算单元,让存储更靠近计算,采用更快的器件,或者改变芯片的堆叠方式,都是可能的选择。与此同时,通信、供电和散热也会发生变化。要知道哪种方案更合适,我们需要从同一个计算任务出发,一直看到它的物理实现。
这也是我们在 ICCC 2026 报告中讨论系统–工艺协同优化(STCO)的出发点。架构决定系统如何组织计算,器件与制造技术决定它可以怎样实现。我们通过物理设计,把这两方面放在一起考虑。下面从我们做的两项工作谈起:电源网络优化,以及跨光罩芯粒布局。
从同一个计算任务出发
我们先固定矩阵维度、数值精度和批大小。在脉动阵列中,数据沿着相邻的乘加单元传递,得以反复使用。提高并行度可以减少计算周期,但存储系统也要及时供给数据。如果把存储移到另一层,通信距离、垂直互连和热量分布又会随之改变。
任务执行时间同时取决于所需周期数与可用频率:
Ttask = Ncycles / frun。
这里的周期数包括计算和等待数据所需的周期,运行频率则取决于实际的信号路径、供电电压和温度。一种数据流即使减少了周期数,如果对应的物理实现只能运行在更低的频率,任务也未必完成得更快。
为了比较这些选择,我们需要逻辑映射、布局布线,以及互连、供电和热分析的结果。再带着这些结果回头看,才能判断并行度、存储位置和工艺方案应该怎样调整。
供电如何影响运行频率
在高密度芯粒系统中,大量计算核心同时切换,会产生明显的电流峰值。微凸点、中介层金属与硅通孔(TSV)的寄生效应,都会影响电源网络的响应。电压跌落会削弱晶体管的驱动能力、增大门延迟,进而限制系统能够运行的频率。
在 CNE-PDN 中,我们从元件级模型入手,把这些效应与版图联系起来。我们利用电磁仿真结果,拟合等效电阻、电感和电容。对于固定的 TSV 结构,可以复用拟合好的参数;对于形状会变化的金属结构,则用神经网络预测参数。之后,再按候选版图的连接关系,把这些元件组合成网络。
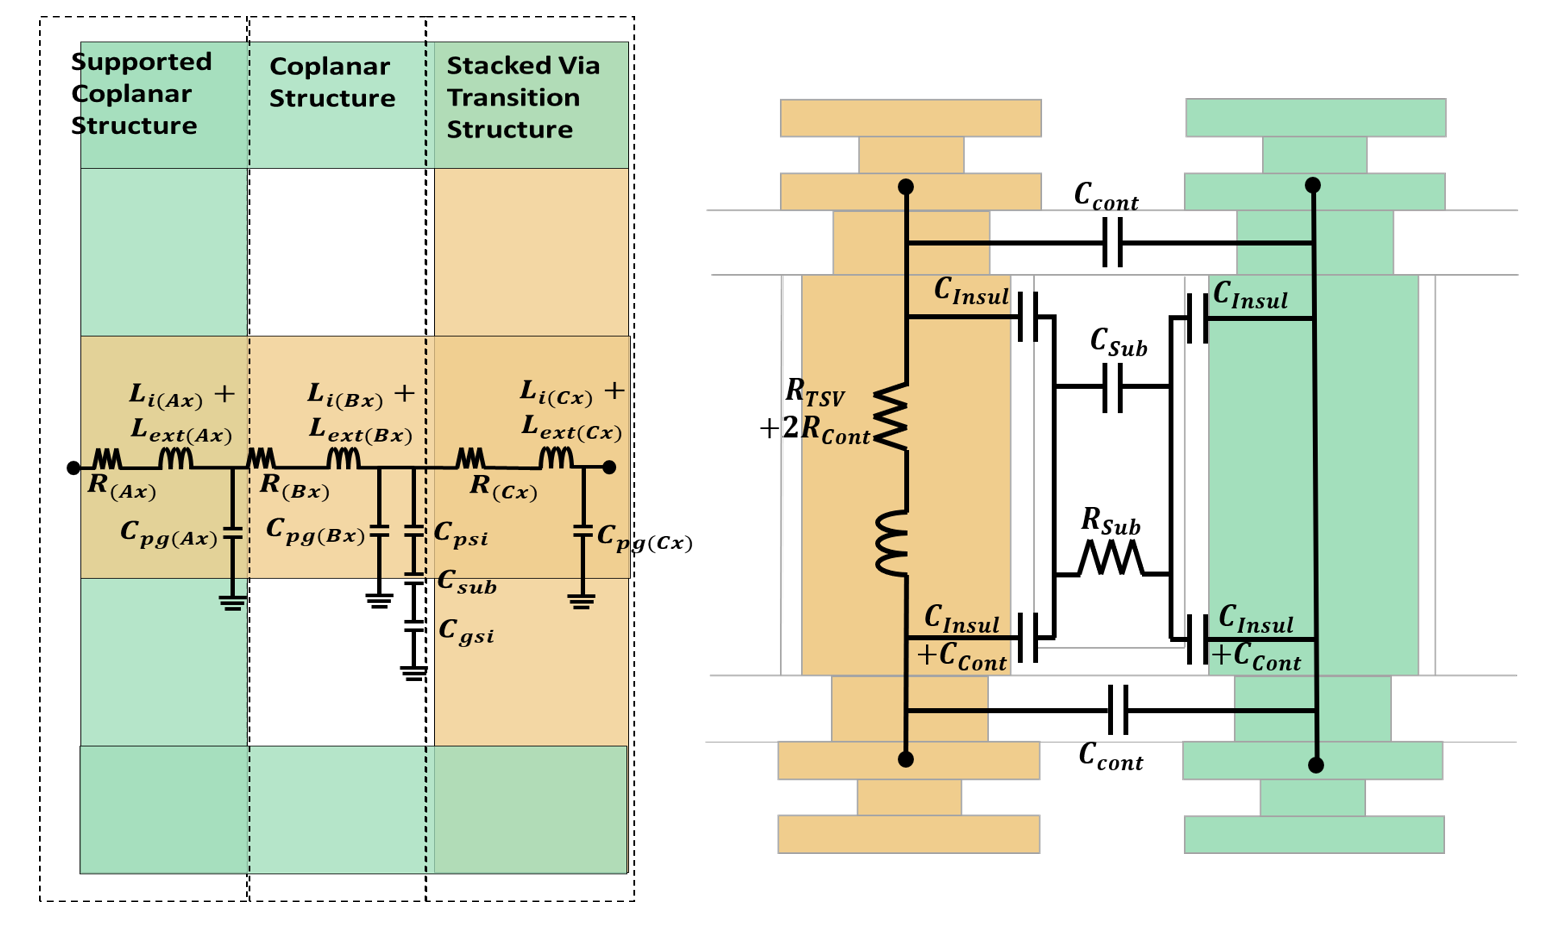
有了网络阻抗和开关电流波形,我们就能求出电压响应,再根据开关时间窗口内的平均电压,估计供电条件所允许的运行频率。这样,金属尺寸或 TSV 位置的变化,就能对应到系统运行频率的变化。
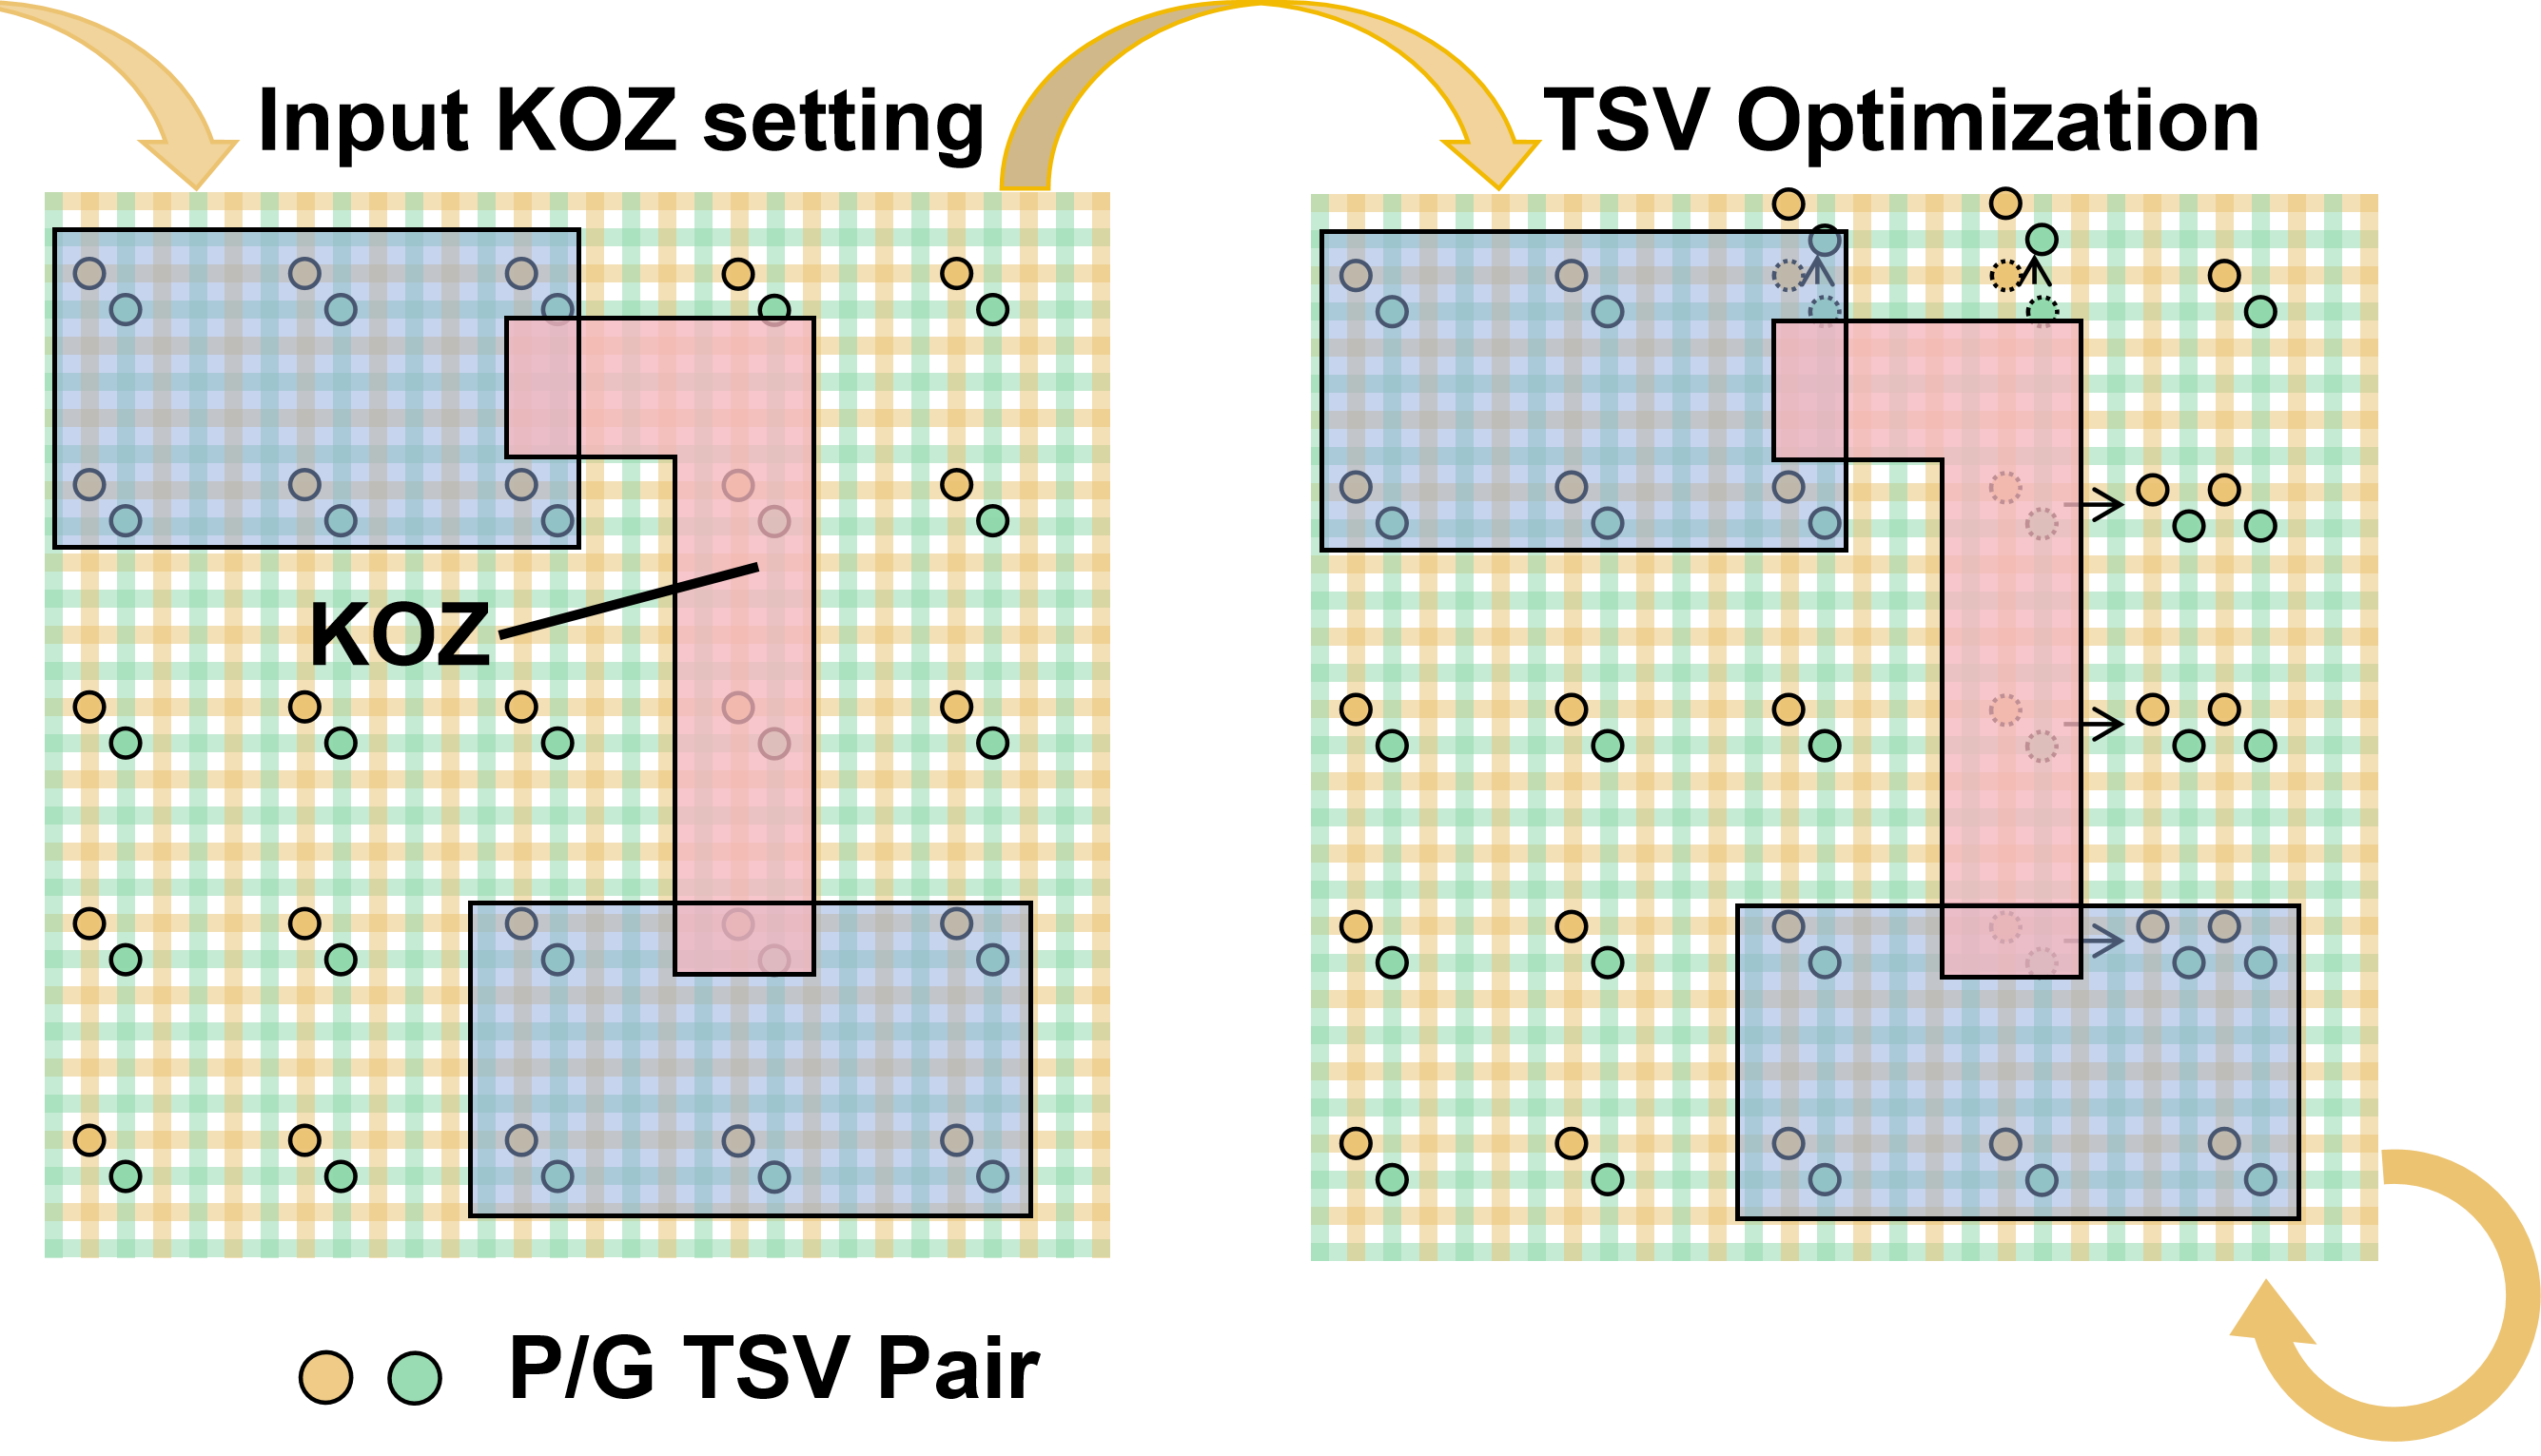
完成拟合与训练后,我们评估一个候选方案约需8秒,而 HFSS–SPICE 流程约需50分钟。这让我们能够同时搜索金属尺寸与 TSV 位置,并把布线拥塞和禁布区域考虑进去。在所评估的 CPU/GPU/HBM 设计中,我们保持芯粒组成和金属尺寸不变,仅调整 TSV 位置,就将估计的供电受限频率从1.935 GHz 提高到了2.029 GHz。
把制造规则带进布局
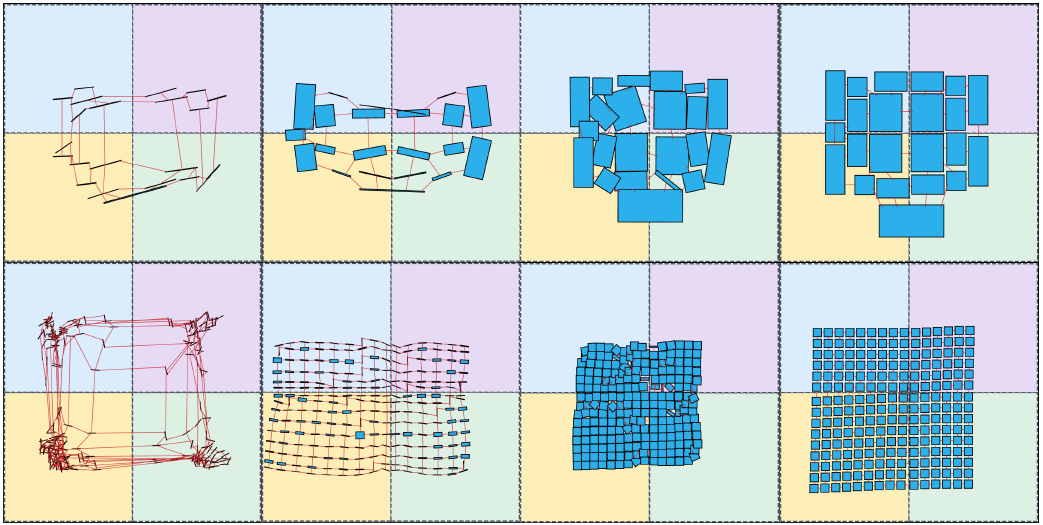
在 ULTRA-2.5D 中,我们关注的是制造约束如何影响芯粒布局。规模较大的芯粒系统,可能需要让中介层跨越多个光刻曝光区域。区域之间需要拼接,边界处的对准问题和布线规则也就必须纳入考虑。
这些规则会影响芯粒放在哪里、引脚怎样连接。例如,一个芯粒可以跨在相邻的曝光区域上,让关键连接留在同一区域内;芯粒的旋转或翻转方向,又可能决定这种安排能否实现。制造约束因此成为布局问题本身的一部分。
为此,我们将多光罩分区、可微的位置与方向优化,以及合法化结合起来,让光罩结构和芯粒连接关系共同参与布局优化。ULTRA-2.5D 完成了七个基准测试,最大规模为1,225个芯粒。在 ATPlace2.5D 也能完成的五个测试中,以几何平均计算,它的总半周长线长是我们方法的1.40倍。
把这些选择放在一起考虑
我们也可以用同样的思路,理解器件与集成方式的选择。器件模型决定单元的延迟、功耗和面积,金属和键合规则决定互连负载。经过映射和物理设计,这些因素落到具体的信号路径上;再通过供电和热分析,我们才能知道系统可以在什么条件下运行。
存储带宽、键合密度和散热条件,也会影响架构选择。计算单元多了,需要的数据和供电也更多;存储靠近了,通信距离缩短,散热路径却可能随之变化。因此,我们最终还是回到计算任务本身:完成它需要多久、消耗多少能量,对应的面积和制造成本又是多少?
在 CNE-PDN 中,我们用物理模型引导版图优化,改善系统可用的运行频率;在 ULTRA-2.5D 中,我们把制造规则带进大规模芯粒布局。通过这些工作,我们能更具体地看到系统与工艺的选择如何影响物理实现,再据此判断下一步应该调整什么。
基于Keren Zhu(朱可人)在 ICCC 2026 的报告《面向三维堆叠芯片的跨层设计自动化与 STCO》。相关工作:CNE-PDN(ICCAD 2026;代码)与 ULTRA-2.5D(IEEE TCAD 2026)。